Geodaten in neuronalen Netzen speichern
Kapitel 11 · Einordnung und Ausblick
Inhalt:
- Wie gut die Ergebnisse dieses Tutorials im Vergleich zur Forschung sind
- Was man bei Rasterdaten noch verbessern könnte
- Ausblick: Wie lassen sich Vektordaten – Punkte, Linien und Flächen – mit neuronalen Netzen darstellen?
Ausgangspunkt
Zehn Kapitel lang ging es um ein einziges Raster: die Höhen der Erde. Das Standardbeispiel speichert 2 332 800 Höhenwerte in 82 561 Gewichten, 14-mal kleiner als das Raster, mit float16 sogar 28-mal (Kapitel 10). Dafür liegt es im Mittel rund 245 m daneben; mit Kontextfeld sind es rund 186 m (Kapitel 8 und Anhang).
Dieses letzte Kapitel ordnet das ein und schaut über das Raster hinaus. Denn viele Geodaten sind gar keine Raster, sondern Punkte, Linien und Flächen.
Einordnung: Warum Huang und Hoefler viel stärker komprimieren
Die Vorlage dieser Reihe, Huang und Hoefler, berichtet Kompressionsraten von 300 bis über 3 000 [1]. Das ist das 10- bis 100-Fache dessen, was hier erreicht wurde. Liegt das an schlechten Netzen?
Zum großen Teil nicht. Es liegt an den Daten:
- Glatte Felder. Huang und Hoefler komprimieren Wetter- und Klimadaten. Solche Felder ändern sich meist gleichmäßig über große Entfernungen. In der Sprache von Kapitel 5: Sie bestehen überwiegend aus langen Wellen. Das Gelände der Erde dagegen ist zerklüftet. Gebirge, Küsten und Tiefseegräben sind kurze Wellen, und jede davon kostet Gewichte.
- Mehr Dimensionen. Ihre Daten sind mehrdimensional, also nicht nur über die Fläche verteilt. Ein Netz, das eine Funktion vieler Koordinaten lernt, kann Ähnlichkeiten zwischen benachbarten Zeitpunkten oder Höhenstufen ausnutzen. Ein einzelnes Höhenraster hat nichts dergleichen: Jede Einzelheit muss aus den Gewichten selbst kommen.
- Größere Datenmengen. Je größer das Original, desto leichter fällt eine hohe Rate, wenn das Netz nicht im gleichen Maß wachsen muss. Das Standardgitter hat gut 2 Millionen Werte, Wetter- und Klimadaten haben oft viele Milliarden.
Für ein einzelnes, zerklüftetes Raster ohne weitere Dimension sind Raten im Bereich von 10 bis 100 deshalb ein realistisches Ergebnis. Genau das macht das Beispiel lehrreich: Die Abwägung zwischen Dateigröße und Fehler ist deutlich zu sehen und nicht hinter einer beeindruckenden Zahl versteckt.
Was man bei Rastern noch verbessern könnte
Drei Richtungen, die in der Forschung verfolgt werden und über dieses Tutorial hinausgehen:
Hash-Gitter. Müller und Kollegen ergänzen ein kleines Netz um Tabellen mit lernbaren Zahlen auf mehreren Auflösungsstufen [2]. Für einen Ort werden die passenden Einträge nachgeschlagen und dem Netz als Eingabe gegeben – eine Weiterentwicklung der Idee des Kontextfelds aus Kapitel 8. Damit kommt man mit einem viel kleineren Netz aus, und das Training geht deutlich schneller. Für die Kompression gilt aber dasselbe wie beim Kontextfeld: Die Tabellen gehören zur Datei und müssen ehrlich mitgezählt werden.
Quantisierung schon beim Training. Kapitel 10 hat gezeigt, dass float16 beim Fourier-MLP fast nichts kostet. Mit 8 Bit oder weniger pro Gewicht würde die Datei noch einmal halb so groß oder kleiner. Damit das funktioniert, rechnet das Netz schon während des Trainings mit den gröberen Zahlen und lernt, mit ihnen zurechtzukommen.
Zeitreihen. Statt f(lon, lat) lernt das Netz f(lon, lat, t), etwa die Temperatur über ein ganzes Jahr. Die Zeit ist einfach eine weitere Eingabe. Bei solchen mehrdimensionalen Daten erreichen Huang und Hoefler ihre hohen Raten.
Ausblick: Vektordaten
Ein Raster ist eine Tabelle von Werten an festen Gitterpunkten. Vektordaten sind etwas anderes: einzelne Objekte mit genauer Geometrie.
- Punkte: Messstationen, Fundorte von Tierarten, Adressen. Jeder Punkt hat eine Koordinate und meist weitere Angaben, etwa einen Messwert oder einen Namen.
- Linien: Flüsse, Straßen, Küsten, Wanderwege. Eine Linie ist eine Folge von Punkten, die der Reihe nach verbunden sind.
- Flächen: Länder, Seen, Gebäudegrundrisse, Schutzgebiete. Eine Fläche ist eine geschlossene Linie, die ein Innen von einem Außen trennt, manchmal mit Löchern.
Ein Netz f(lon, lat) gibt für jeden Ort eine Zahl aus. Ein Fluss ist aber keine Zahl an jedem Ort. Wie bringt man beides zusammen? In der Forschung gibt es zwei Wege, und sie verfolgen ganz verschiedene Ziele.
Weg 1: Vektordaten in ein Feld verwandeln
Der erste Weg macht aus den Vektordaten ein Feld – eine Größe, die an jedem Ort einen Wert hat. Dieses Feld lässt sich dann genauso mit einem Netz speichern wie die Höhen in diesem Tutorial.
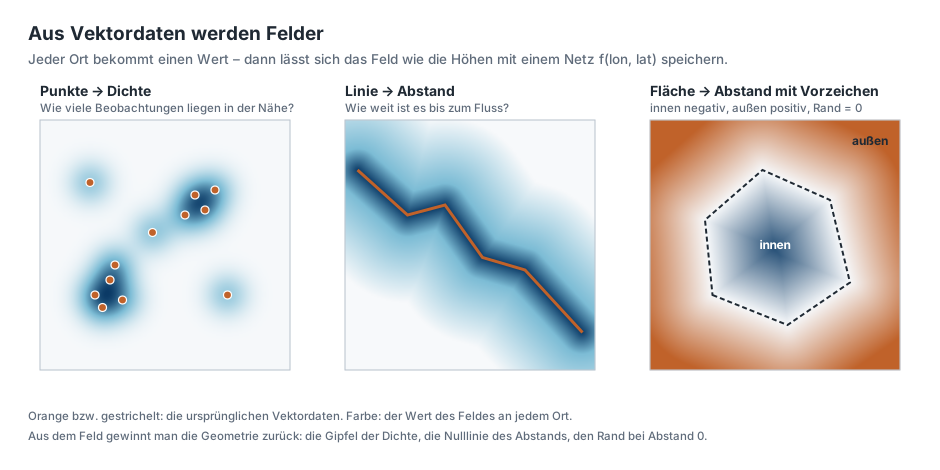
Punkte werden zu einer Dichte. Für jeden Ort fragt man: Wie viele Punkte liegen in der Nähe? Oder bei Fundorten einer Tierart: Wie wahrscheinlich ist es, die Art hier anzutreffen? Cole und Kollegen haben so mit einem einzigen Netz die Verbreitungsgebiete von 47 000 Tier- und Pflanzenarten gelernt, aus Millionen von Beobachtungen, die Freiwillige gemeldet haben [3]. Ihr Netz bekommt eine Koordinate und gibt für jede Art eine Wahrscheinlichkeit aus – ein Feld, wie in diesem Tutorial, nur mit 47 000 Ausgaben statt einer.
Haben die Punkte Messwerte, etwa Temperaturen an Wetterstationen, lernt das Netz direkt das Feld zwischen den Stationen. Anders als bei den Höhen gibt es dann aber kein vollständiges Raster: Das Netz muss zwischen wenigen Punkten verallgemeinern, und man braucht wieder Testdaten wie beim gewöhnlichen Training (Kapitel 2).
Linien werden zu einem Abstand. Für jeden Ort fragt man: Wie weit ist es bis zum nächsten Fluss, zur nächsten Straße, zur Küste? Direkt auf der Linie ist der Abstand null, daneben wächst er gleichmäßig an. Ein solches Abstandsfeld ist glatt und lässt sich gut lernen.
Flächen werden zu einem Abstand mit Vorzeichen. Für eine Fläche nimmt man den Abstand zum Rand und gibt ihm ein Vorzeichen: innen negativ, außen positiv. Der Rand selbst ist genau die Linie, an der das Feld null ist. Diese Darstellung heißt signed distance function, auf Deutsch vorzeichenbehaftete Abstandsfunktion. Bekannt geworden ist sie für 3D-Formen durch DeepSDF von Park und Kollegen [4]; Chu und Shahabi verwenden dieselbe Idee für Punkte, Linien und Flächen in Geodaten [5]. Noch einfacher ist ein Feld, das nur angibt, ob ein Ort innen liegt (1) oder außen (0), etwa „Land oder Meer?“ oder „In welchem Land liegt dieser Punkt?“.
Die Geometrie zurückgewinnen. Aus dem Feld bekommt man die Vektordaten wieder heraus: die Gipfel der Dichte, die Nulllinie des Abstands, den Rand bei null. Das lässt sich sogar mit dem Netz dieses Tutorials zeigen. Die Küste ist die Linie, an der die Höhe genau 0 m ist:
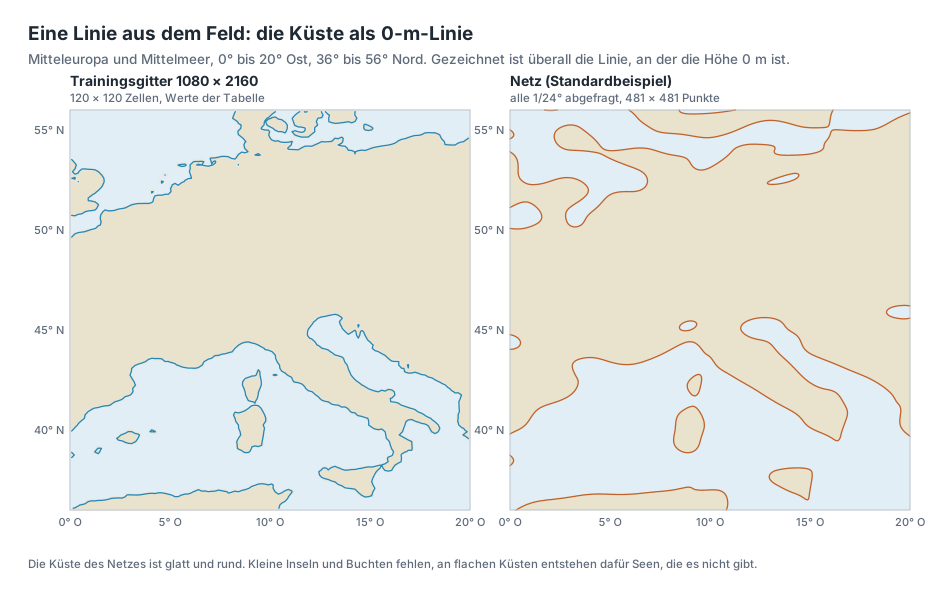
Bezogen auf die Fläche liegt das Standardbeispiel bei 97 % der Erdoberfläche auf der richtigen Seite – Land, wo Land ist, Meer, wo Meer ist. An den Küsten selbst, in Zellen mit Höhen zwischen −200 m und +200 m, sind es nur noch 80 %. Genau dort, wo die Linie verläuft, ist das Netz am unsichersten.
Die Grenzen dieses Wegs. Vektordaten sind meist schon sehr kompakt: Eine Küstenlinie ist eine Liste von Koordinaten, genau bis auf Zentimeter. Ein Feld gibt diese Genauigkeit auf. Es weiß auch nichts von Regeln, die für Vektordaten wichtig sind – dass zwei Nachbarländer genau dieselbe Grenze teilen, dass eine Straße ohne Lücke verbunden ist oder wie ein Fluss heißt. Ob ein neuronales Feld bei Vektordaten Speicher spart, ist deshalb eine offene Frage; nützlich ist es vor allem dann, wenn man die Daten ohnehin als Feld braucht, etwa „Wie weit ist jeder Ort vom nächsten Krankenhaus entfernt?“.
Weg 2: Jedes Objekt wird zu einem Zahlenvektor
Der zweite Weg will Vektordaten nicht speichern, sondern für maschinelles Lernen nutzbar machen. Viele Aufgaben brauchen eine Geometrie als Eingabe: Ist dieser Grundriss ein Wohnhaus oder eine Fabrik? Liegt dieser See in jenem Schutzgebiet? Wie viele Menschen wohnen in diesem Stadtviertel?
Ein Netz kann aber keine Liste von Koordinaten unterschiedlicher Länge verarbeiten. Deshalb übersetzt ein Encoder jedes Objekt in einen Zahlenvektor fester Länge, etwa 256 Zahlen. Ähnliche Objekte sollen dabei ähnliche Zahlen bekommen. Diese Zahlen heißen Embedding.
- Punkte: Für einen einzelnen Ort gibt es location encoder. Sie arbeiten meist mit Sinus- und Kosinuswellen in vielen Größen – genau wie die Fourier-Features aus Kapitel 5. Space2Vec von Mai und Kollegen ist ein frühes Beispiel [6]; SatCLIP von Klemmer und Kollegen lernt die Zahlen für jeden Ort der Erde aus Satellitenbildern [7]. Mai und Kollegen geben einen Überblick über diese Verfahren [8].
- Flächen: Mai und Kollegen beschreiben einen Polygon-Encoder, der die Form einer Fläche über eine Fourier-Transformation erfasst. Er ist robust dagegen, dass man dieselbe Fläche unterschiedlich beschreiben kann, etwa mit einem anderen Startpunkt oder zusätzlichen Eckpunkten [9].
- Alle drei Arten: Poly2Vec von Siampou und Kollegen behandelt Punkte, Linien und Flächen mit demselben Verfahren, ebenfalls über eine Fourier-Transformation. Das Netz kann damit Beziehungen wie „berührt“, „liegt nördlich von“ oder „ist 3 km entfernt“ zwischen beliebigen Objekten erkennen [10]. Auch das Verfahren von Chu und Shahabi aus Weg 1 erzeugt solche Zahlenvektoren, aus dem Abstandsfeld jedes Objekts [5].
Hier ist das Netz also nicht die Datei, sondern ein Übersetzer. Die Vektordaten bleiben, wie sie sind; das Netz liefert zusätzlich eine Darstellung, mit der andere Netze rechnen können.
Die beiden Wege im Vergleich
| Weg 1: Feld | Weg 2: Zahlenvektor pro Objekt | |
|---|---|---|
| Ziel | Daten als Funktion speichern oder abfragen | Objekte für maschinelles Lernen nutzbar machen |
| Eingabe des Netzes | eine Koordinate | ein ganzes Objekt |
| Ausgabe | ein Wert an diesem Ort | ein Zahlenvektor fester Länge |
| Verwandt mit | diesem Tutorial | den Fourier-Features aus Kapitel 5 |
| Beispiele | Verbreitung von Arten [3], Abstandsfelder [4, 5] | Space2Vec [6], SatCLIP [7], Polygon-Encoder [9], Poly2Vec [10] |
Beiden Wegen gemeinsam ist der Grundgedanke dieser Reihe: Statt Geodaten als Tabelle oder Liste zu behandeln, beschreibt man sie als Funktion – und lässt ein Netz lernen, wie diese Funktion aussieht.
Ideen zum Weiterprobieren
- Im Reiter Maps & Error die Fehlerkarte an den Küsten ansehen. Wo würde das Netz Land und Meer verwechseln?
- Die Küste aus Netzen verschiedener Größe vergleichen, etwa Fourier MLP, very small gegen Fourier MLP, large, im Reiter Super-Resolution bei 2° Fenster. Ab welcher Größe stimmen die Umrisse von Korsika?
- Überlegen, welche eigenen Geodaten sich gut als Feld eignen würden – und welche schlecht. Hilfreich ist die Frage: Hat der Wert an jedem Ort eine Bedeutung, oder nur auf einzelnen Objekten?
- Wer Daten aus OpenStreetMap kennt: Für eine Stadt den Abstand jedes Ortes zur nächsten Haltestelle als Raster berechnen. Das ist ein Feld wie in Weg 1 – und ließe sich mit der App genau wie die Höhen trainieren, wenn man es als Datenquelle einbindet.
Weiterführende Links
- [1] Huang und Hoefler: Compressing multidimensional weather and climate data into neural networks, ICLR 2023 – Kompressionsraten von 300 bis über 3 000 für Wetter- und Klimadaten (Englisch)
- [2] Müller et al.: Instant Neural Graphics Primitives with a Multiresolution Hash Encoding, SIGGRAPH 2022 – Hash-Gitter mit lernbaren Tabellen auf mehreren Auflösungsstufen (Englisch)
- [3] Cole et al.: Spatial Implicit Neural Representations for Global-Scale Species Mapping, ICML 2023 – ein Netz für die Verbreitung von 47 000 Arten aus Fundpunkten (Englisch)
- [4] Park et al.: DeepSDF: Learning Continuous Signed Distance Functions for Shape Representation, CVPR 2019 – vorzeichenbehaftete Abstandsfunktionen als neuronales Feld (Englisch)
- [5] Chu und Shahabi: Geo2Vec: Shape- and Distance-Aware Neural Representation of Geospatial Entities, 2025 – Abstandsfelder für Punkte, Linien und Flächen in Geodaten (Englisch)
- [6] Mai et al.: Multi-Scale Representation Learning for Spatial Feature Distributions using Grid Cells, ICLR 2020 – Space2Vec, Wellen in vielen Größen als Kodierung von Orten (Englisch)
- [7] Klemmer et al.: SatCLIP: Global, General-Purpose Location Embeddings with Satellite Imagery, AAAI 2025 – Zahlenvektoren für jeden Ort der Erde, gelernt aus Satellitenbildern (Englisch)
- [8] Mai et al.: A Review of Location Encoding for GeoAI: Methods and Applications, IJGIS 2022 – Überblick über die Kodierung von Orten, Linien, Flächen und Rastern (Englisch)
- [9] Mai et al.: Towards General-Purpose Representation Learning of Polygonal Geometries, GeoInformatica 2022 – Polygon-Encoder über eine nicht gleichmäßige Fourier-Transformation (Englisch)
- [10] Siampou et al.: Poly2Vec: Polymorphic Fourier-Based Encoding of Geospatial Objects for GeoAI Applications, ICML 2025 – ein Verfahren für Punkte, Linien und Flächen (Englisch)
Übersicht · Zurück: Kapitel 10 · Abfragen und exportieren · Weiter: Anhang · Messungen
Dieses Tutorial wurde von Gerhard Völkl unter Verwendung von Claude Code (Anthropic) erstellt. Es soll helfen, mehr über das Thema „Geodaten in neuronalen Netzen speichern“ zu lernen. Verbesserungsvorschläge gerne an gkvoelkl@nelson-games.de.